
در دنیای امروز، عبارت «یادگیری ماشین» یا همان (Machine Learning (ML تقریباً همه جا شنیده میشود؛ از پیشنهاد فیلم گرفته تا فیلتر اسپم در ایمیل و تحلیل داده های پزشکی. اما یادگیری ماشین دقیقاً چیست؟ چگونه کار میکند؟ و چرا اینقدر مهم شده است؟
در این مقاله، به زبان ساده یادگیری ماشین را بررسی میکنیم؛ انواع آن را میشناسیم، کاربردهایش را مرور میکنیم، ابزارهای رایج را معرفی میکنیم و در پایان به سوالات پرتکرار پاسخ میدهیم.
Machine Learning چیست؟
یادگیری ماشین شاخهای از هوش مصنوعی (AI) است که به سیستم ها اجازه میدهد بدون برنامه نویسی صریح، از داده ها یاد بگیرند و عملکردشان را بهبود دهند. به بیان دیگر، به جای اینکه الگوریتم را خط به خط کدنویسی کنیم، مدل یادگیری ماشین خودش الگوها را از روی داده ها پیدا میکند.
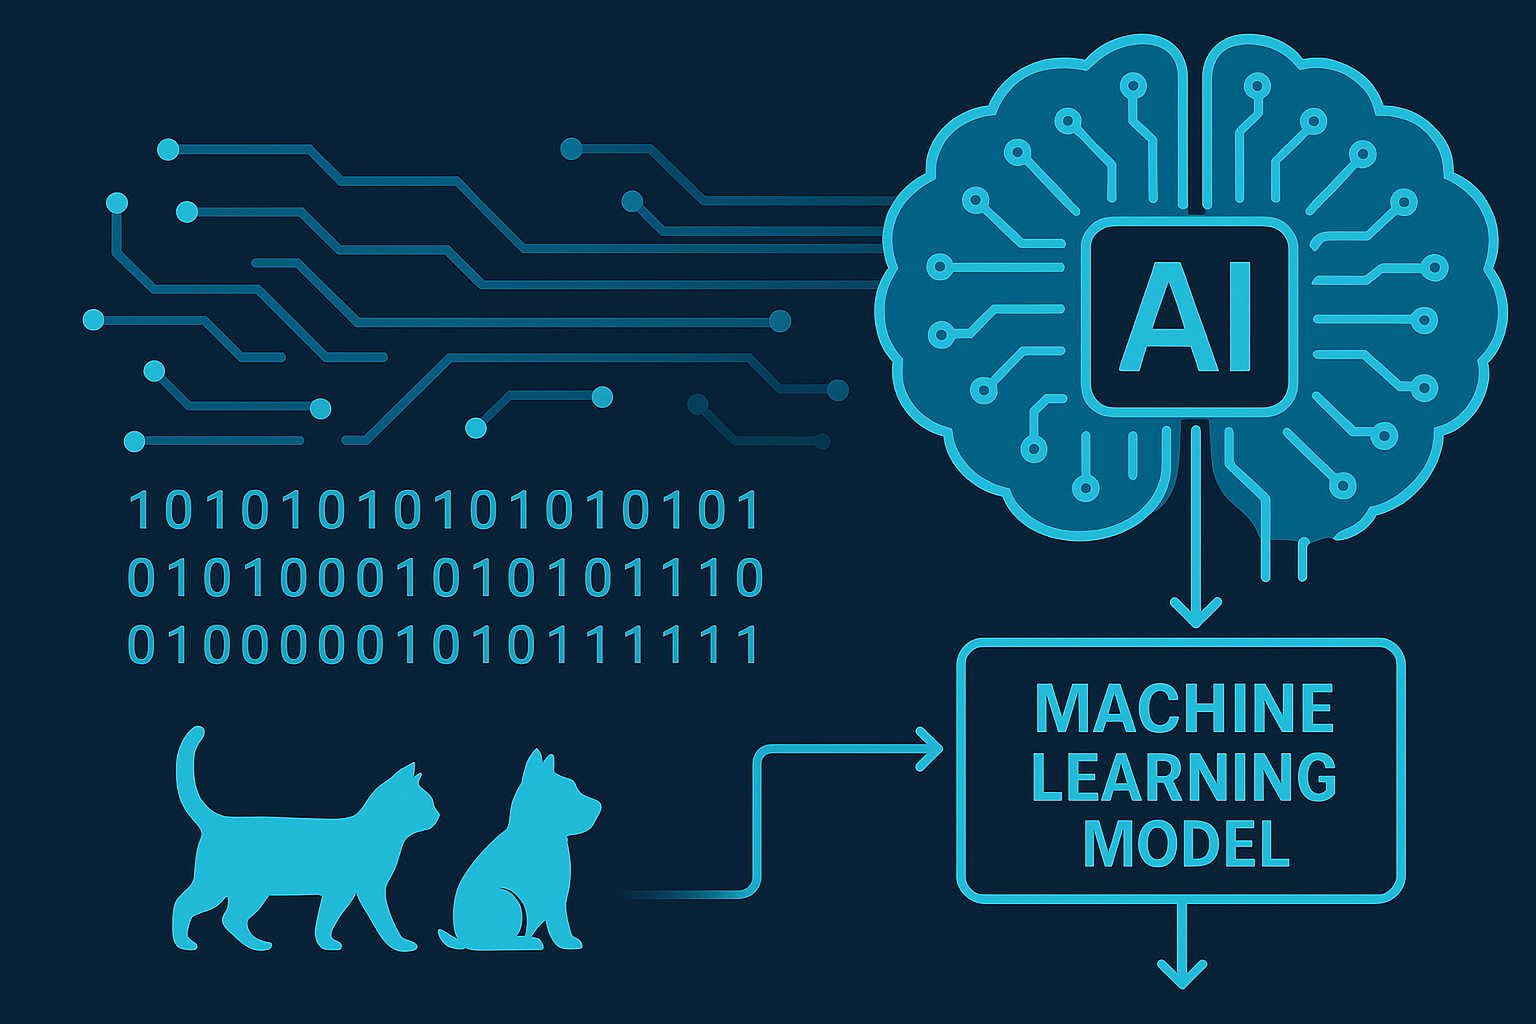
برای مثال: اگر هزاران تصویر گربه و سگ به یک الگوریتم یادگیری ماشین بدهیم، مدل میتواند یاد بگیرد که ویژگیهای هرکدام چیست و بعد تصویر جدید را بهدرستی دستهبندی کند.
انواع یادگیری ماشین
یادگیری ماشین به طور کلی به سه دسته اصلی تقسیم میشود:
یادگیری تحت نظارت Supervised Learning
در این روش، داده ها همراه با «برچسب» یا «خروجی صحیح» به مدل داده میشوند. مدل سعی میکند رابطه بین ورودی و خروجی را یاد بگیرد. مثل:
- پیش بینی قیمت خانه بر اساس متراژ و منطقه
- تشخیص ایمیل های اسپم
الگوریتم های رایج: Linear Regression، Decision Trees، Random Forest، SVM، Neural Networks
یادگیری بدون نظارت Unsupervised Learning
در این حالت، داده ها بدون برچسب هستند و هدف کشف الگوهای پنهان در داده است. مثل:
- خوشه بندی مشتریان برای بازاریابی هدفمند
- تشخیص تقلب در تراکنش ها
الگوریتم های رایج: K-Means، DBSCAN، PCA، Autoencoders
یادگیری تقویتی Reinforcement Learning
در این رویکرد، مدل با محیط تعامل دارد و از طریق پاداش و جریمه یاد میگیرد چگونه تصمیمگیری کند. مثل:
- یادگیری بازی کردن شطرنج یا بازی های ویدیویی
- بهینه سازی ترافیک شبکه یا مسیر ربات
الگوریتم های رایج: ( Q-Learning، Deep Q-Network (DQN)، Proximal Policy Optimization (PPO
فرایند کلی اجرای یک پروژه یادگیری ماشین (ML Workflow)
اگرچه یادگیری ماشین با الگوریتم ها و مدل ها شناخته میشود، اما در عمل، اجرای یک پروژه ML نیازمند مجموعهای از مراحل منظم و به هم پیوسته است. در ادامه، مراحل رایج یک پروژه یادگیری ماشین را بررسی میکنیم:
1- تعریف مسئله (Problem Definition)
اول باید هدف پروژه مشخص شود. آیا هدف پیش بینی یک مقدار عددی (مثلاً قیمت خانه) است یا طبقهبندی (مثلاً تشخیص اسپم یا غیراسپم بودن ایمیل)؟ درک دقیق مسئله راهنمای خوبی برای انتخاب مدل و داده هاست.
2- جمعآوری داده ها (Data Collection)
کیفیت و حجم داده ها نقش حیاتی در موفقیت مدل دارند. داده ها ممکن است از دیتابیس ها، API ها، فرم ها یا فایل های لاگ استخراج شوند.
3- پاکسازی و آماده سازی داده ها (Data Cleaning & Preprocessing)
حذف مقادیر گمشده، نرمال سازی ویژگی ها، تبدیل داده های متنی به عددی، حذف داده های پرت و یکدست سازی ساختار داده ها از جمله مراحل ضروری در این گام است.
4- تحلیل اکتشافی داده ها (EDA)
در این مرحله با استفاده از آمار توصیفی و نمودارها، به درک بهتری از توزیع ویژگی ها، همبستگی ها و الگوهای پنهان میرسیم.
5- مهندسی ویژگی (Feature Engineering)
ساخت ویژگی های جدید، انتخاب مهمترین ویژگی ها و کاهش ابعاد داده ها (مثلاً با PCA) میتواند تأثیر زیادی در دقت مدل داشته باشد.
6- انتخاب و آموزش مدل (Model Selection & Training)
بسته به نوع مسئله و داده، یک یا چند الگوریتم ML انتخاب شده و روی داده های آموزشی، آموزش میبینند.
7- ارزیابی مدل (Evaluation)
با استفاده از داده های تست و معیارهایی مانند دقت (accuracy)، دقت مثبت (precision)، بازخوانی (recall) و F1-score عملکرد مدل سنجیده میشود.
8- استقرار مدل (Deployment)
مدل نهایی در قالب API یا برنامه ای تحت وب پیاده سازی میشود تا در محیط واقعی قابل استفاده باشد.
اگر قصد اجرای مدل ها در محیط واقعی یا تست اولیه روی سرور دارید، استفاده از VPS ابرآراد یک مسیر مقرون به صرفه و انعطاف پذیر برای استقرار پروژه های ML محسوب میشود.
9- مانیتورینگ و بروزرسانی (Monitoring)
مدل های ML ممکن است در گذر زمان عملکردشان کاهش یابد (بهدلیل تغییر در داده ها یا شرایط). بنابراین پایش مداوم و بروزرسانی دورهای ضروری است.
نکته:
- پیروی از این چرخه، نه تنها باعث بهبود عملکرد فنی مدل میشود، بلکه ساختار ذهنی مناسبی برای مدیریت پروژه های یادگیری ماشین ایجاد میکند.
- انتخاب الگوریتم مناسب کاملاً وابسته به نوع داده، هدف مسئله، محدودیت منابع و نیاز به تفسیر پذیری مدل است.
محصولات ابر آراد را ببینید و مشخصات هر سرویس را مقایسه کنید.
مقایسه الگوریتم های رایج یادگیری ماشین
الگوریتمهای یادگیری ماشین بسته به نوع داده، هدف پروژه، منابع محاسباتی و میزان تفسیرپذیری مورد انتظار انتخاب میشوند. در ادامه، نگاهی میاندازیم به برخی از الگوریتمهای پرکاربرد، نقاط قوت، محدودیتها و موارد استفاده آنها:
1- الگوریتم های خطی: ساده اما قدرتمند
الگوریتم هایی مانند Linear Regression و Logistic Regression از اولین و پراستفادهترین مدل ها در یادگیری ماشین هستند. آنها با فرض وجود رابطه خطی میان ویژگی ها و خروجی، امکان تحلیل سریع داده ها را فراهم میکنند.
نکات مثبت: سرعت بالا، قابل تفسیر بودن، مناسب برای داده های کوچک
محدودیت: عملکرد ضعیف در مسائل پیچیده با روابط غیرخطی
2- درخت تصمیم و Random Forest: قابل فهم و تطبیق پذیر
درخت تصمیم (Decision Tree) با ساختار شاخهای خود تصمیمگیری را مرحله به مرحله انجام میدهد. Random Forest با ترکیب چند درخت مختلف، دقت مدل را افزایش میدهد و از بیش برازش (Overfitting) جلوگیری میکند.
نکات مثبت: مناسب برای داده های ترکیبی (عددی و متنی)، قدرت پیش بینی بالا، انعطاف پذیر
محدودیت: Random Forest ممکن است سنگین و کند باشد
3- الگوریتم های مبتنی بر همسایگی: KNN
(K-Nearest Neighbors (KNNبر اساس تشابه بین داده ها پیش بینی میکند. این مدل برای مسائل دسته بندی و گاهی رگرسیون استفاده میشود.
نکات مثبت: پیاده سازی ساده، بدون نیاز به آموزش واقعی
محدودیت: کندی در داده های حجیم، حساس به مقیاس ویژگی ها
4- الگوریتم های مبتنی بر بیز: Naive Bayes
این الگوریتم ها بر پایه تئوری احتمال بیز و فرض استقلال بین ویژگی ها عمل میکنند.
نکات مثبت: سریع و مناسب برای متن کاوی (مثلاً دسته بندی ایمیل یا تحلیل احساسات)
محدودیت: فرض استقلال کامل ویژگی ها همیشه واقع بینانه نیست
5- مدل های بردار پشتیبان (SVM): دقیق اما پیچیده
SVM با یافتن یک مرز تصمیمگیری (Hyperplane) سعی میکند کلاسها را با بیشترین فاصله جدا کند.
نکات مثبت: عملکرد بالا در مسائل پیچیده
محدودیت: پیاده سازی سخت، تنظیم پارامترها چالش برانگیز است
6- الگوریتم های مبتنی بر شبکه عصبی: یادگیری عمیق
مدل هایی مانند شبکه های عصبی مصنوعی (ANN) یا CNN و RNN در حوزه هایی مثل بینایی ماشین، ترجمه ماشینی یا گفتار به کار میروند.
نکات مثبت: توانایی کشف الگوهای پیچیده، قدرت بالا در پردازش داده های تصویر، متن و صوت
محدودیت: نیاز به داده زیاد، منابع محاسباتی بالا، پیچیدگی پیاده سازی
در بسیاری از پروژه های یادگیری ماشین، مخصوصاً مدل های عمیق، استفاده از GPU ابری میتواند سرعت آموزش مدل را چندین برابر افزایش دهد و هزینه زیرساخت را بهینه کند.
خطاهای رایج در یادگیری ماشین
در حین کار با یادگیری ماشین، برخی اشتباهات متداول میتوانند باعث کاهش دقت مدل یا تفسیر نادرست نتایج شوند:
1- استفاده از داده های نامتوازن بدون اصلاح
در مسائل طبقه بندی (مثلاً تشخیص بیماری)، ممکن است داده های یک کلاس بسیار کمتر از کلاس دیگر باشند. استفاده بدون اصلاح میتواند مدل را به سمت اکثریت متمایل کند.
2- عدم تفکیک درست داده ها به آموزش و آزمون
استفاده اشتباه از داده ها باعث نشت داده (Data Leakage) میشود و اعتبار ارزیابی مدل را زیر سؤال میبرد.
3- تکیه بیش از حد بر معیار Accuracy
در مسائل نامتوازن (مثلاً تشخیص کلاهبرداری) accuracy ممکن است گمراه کننده باشد. معیارهایی مانند Precision، Recall و AUC کاربردیتر هستند.
4- انتخاب ویژگی های بیش از حد یا بیربط
ویژگی های بیربط میتوانند مدل را گیج کرده و باعث افت دقت شوند. مهندسی ویژگی ها نقش حیاتی دارد.
5- عدم بررسی Overfitting / Underfitting
بررسی منحنی آموزش و تست و استفاده از تکنیکهایی مثل Cross-Validation کمک میکند تا مدل تعادل بین دقت و تعمیم پذیری داشته باشد.
6- نادیده گرفتن ارزیابی مدل در محیط واقعی
حتی مدل های دقیق در محیط آزمایشگاهی، ممکن است در دنیای واقعی عملکرد خوبی نداشته باشند. مانیتورینگ پس از استقرار بسیار مهم است.
کاربردهای مهم یادگیری ماشین در دنیای واقعی
یادگیری ماشین تقریباً در همهی حوزهها حضور دارد:
- سرگرمی: پیشنهاد فیلم ها در نتفلیکس یا یوتیوب
- فیلتر اسپم در جیمیل
- تحلیل داده های مالی و تشخیص تقلب بانکی
- پزشکی: تشخیص بیماریها از تصاویر پزشکی یا آزمایشها
- صنعت: پیش بینی خرابی تجهیزات (Predictive Maintenance)
- پردازش زبان طبیعی (NLP): چت بات ها، ترجمه ماشینی، تحلیل احساسات
- خودروهای خودران و تصمیمگیری در لحظه
- پردازش تصویر، مدل های ML برای تشخیص چهره یا اشیاء
در حوزه هایی مثل بینایی ماشین، پردازش تصویر و تشخیص الگو، بهرهگیری از VGC ابرآراد نه تنها سرعت پردازش را افزایش میدهد بلکه امکان اجرای مدل های پیچیدهتر را فراهم میکند.
ترندهای یادگیری ماشین در سال ۲۰۲۵
با پیشرفت سریع هوش مصنوعی، یادگیری ماشین نیز شاهد تغییرات و نوآوریهای قابل توجهی در سال ۲۰۲۵ بوده است. برخی از ترندهای مهم عبارتند از:
1- ترکیب ML با مدل های زبانی بزرگ (LLMs)
مدل های زبانی مانند ChatGPT یا Claude اکنون با مدل های یادگیری ماشین سنتی ترکیب میشوند تا وظایف پیچیدهتری مانند تحلیل داده های متنی یا تولید داده انجام دهند.
2- AutoML و هوش مصنوعی مولد در طراحی مدل ها
ابزارهایی مانند Google AutoML یا H2O.ai امکان ساخت مدل های ML بدون نیاز به دانش برنامه نویسی را فراهم کردهاند. این ابزارها انتخاب مدل، تنظیم پارامترها و ارزیابی را خودکار انجام میدهند.
3- یادگیری ماشین در Edge و IoT
در سال ۲۰۲۵ مدل های سبکوزن ML در دستگاههایی مانند موبایل، حسگرها و خودروها اجرا میشوند. این امکان باعث پردازش بلادرنگ و کاهش مصرف پهنای باند شده است.
4- امنیت و اخلاق در یادگیری ماشین
توجه به fairness، حذف bias، و جلوگیری از استفادههای نادرست از مدل ها از ترندهای مهم سال جاری است. سازمانها در حال تعریف چارچوبهای اخلاقی برای توسعه مدل ها هستند.
5- یادگیری تقویتی (Reinforcement Learning) در تصمیمگیریهای پیچیده
استفاده از RL در حوزههایی مثل بازی، تجارت الگوریتمی، و رباتیک همچنان در حال رشد است و با کمک GPU و مدل های ترکیبی قدرتمندتر شده است.
6- استفاده گسترده از یادگیری فدرال (Federated Learning)
برای حفظ حریم خصوصی کاربران، شرکتها داده را روی دستگاه کاربران نگهمیدارند و مدل را بهصورت توزیع شده آموزش میدهند. این رویکرد در حوزه سلامت، فین تک و موبایل کاربرد زیادی دارد.
آینده یادگیری ماشین، ترکیبی از قدرت پردازشی، دقت مدل، درک انسانی و مسئولیت پذیری اجتماعی است.
چالش های یادگیری ماشین
با وجود همه مزایا، یادگیری ماشین بدون مشکل نیست:
- نیاز به دادهی زیاد و با کیفیت
- مشکل Overfitting (یادگیری بیش از حد از داده های آموزش و عملکرد ضعیف روی داده های جدید)
- شفاف نبودن مدل های پیچیده (مثل شبکههای عصبی)، که به آن Black Box میگویند
- تبعیض (Bias) در داده ها که ممکن است تصمیمات ناعادلانه ایجاد کند
- نیاز به توان محاسباتی بالا (خصوصاً در مدل های deep learning)
در پروژه هایی که داده های حساس دارند، مثل پزشکی، مالی یا سیستم های تشخیص هویت، بستر VPC (ابرخصوصی ابرآراد) نقش کلیدی در ایزوله سازی، کنترل دسترسی و افزایش امنیت فرآیند یادگیری ماشین ایفا میکند.
ابزارها و کتابخانههای رایج در یادگیری ماشین
برای پیاده سازی مدل های ML، ابزارها و فریم ورک های زیادی وجود دارد. معروفترین آنها:
| ابزار/کتابخانه | زبان | کاربرد |
| Scikit-learn | Python | الگوریتمهای ساده و متوسط |
| TensorFlow | Python | یادگیری عمیق (Deep Learning) |
| PyTorch | Python | یادگیری عمیق و تحقیقاتی |
| XGBoost | Python/R | مدلهای تقویتی برای دادههای جدولی |
| RapidMiner | بدون کدنویسی | ساخت مدل با رابط گرافیکی |
| Weka | Java | یادگیری ماشین سنتی با رابط گرافیکی |
سؤالات متداول
1- آیا یادگیری ماشین فقط برای برنامه نویس هاست؟
خیر. بسیاری از پلتفرمها مثل Google AutoML، RapidMiner و حتی Excel افزونههایی دارند که بدون کدنویسی هم میتوان ML را تجربه کرد. البته درک مفاهیم پایه ضروری است.
2- تفاوت AI، Machine Learning و Deep Learning چیست؟
AI (هوش مصنوعی) مفهومی کلی است. ML زیرمجموعهای از AI است که روی یادگیری از داده تمرکز دارد. Deep Learning هم یکی از روش های ML است که با شبکه های عصبی کار میکند.
3- برای یادگیری ماشین بهتر است با کد شروع کنم یا مفاهیم؟
حتماً از مفاهیم شروع کنید، درک درست داده ها، انواع الگوریتم ها و نحوه ارزیابی اهمیت بیشتری نسبت به کدنویسی صرف دارد.
4- برای شروع چه منابعی را پیشنهاد میدهید؟
- دورههای رایگان مثل Coursera ML by Andrew Ng
- کتاب Hands-On Machine Learning with Scikit-Learn, Keras & TensorFlow
- یوتیوب کانالهایی مثل StatQuest یا Krish Naik
- پلتفرمهایی مثل Kaggle برای تمرین عملی
5- آیا یادگیری ماشین فقط برای داده های بزرگ است؟
خیر. حتی با داده های کوچک هم میتوان الگوریتم هایی مثل Logistic Regression یا KNN را پیاده سازی کرد. اما هرچه داده بیشتر، کیفیت مدل بالاتر.
از صفحه تماس ابر آراد، مسیر ارتباط با تیم را انتخاب کنید.
دیدگاهها و پرسشهای شما
تجربه یا پرسش خود را درباره موضوع مقاله با ما در میان بگذارید.
هنوز دیدگاهی ثبت نشده است؛ شما گفتوگو را شروع کنید.